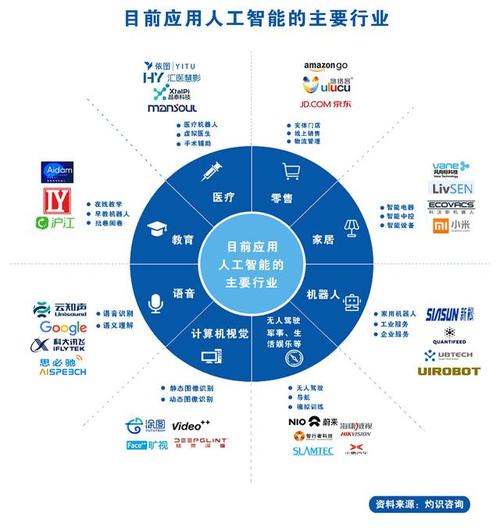
人工智能与机器学习 从基础到进阶指南
第一部分:人工智能基础软件开发概览\n\n人工智能(AI)与机器学习(ML)正在重塑软件开发的本质。传统软件依赖程序员显式编写的规则,而AI基础软件的核心在于从数据中学习模式,并做出预测或决策。这一转变带来了新的工具、框架和工程实践。\n\n### 1.1 什么是AI基础软件开发?\n\nAI基础软件开发是指构建支持AI模型训练、推理和部署的底层系统与工具。它包括:\n- 数学库与计算框架:如NumPy、TensorFlow、PyTorch,提供张量运算和自动微分。\n- 数据处理管道:如Pandas、Apache Spark,用于清洗、转换和特征工程。\n- 模型训练与调优工具:如scikit-learn、Keras、Optuna,简化实验管理。\n- 部署与监控:如ONNX、TensorRT、MLflow,将模型转化为生产级服务。\n\n### 1.2 从基础到进阶的学习路径\n\n1. 数学与编程基础:线性代数、概率统计、Python编程。\n2. 机器学习入门:监督学习(线性回归、决策树)、无监督学习(聚类、降维)。\n3. 深度学习:神经网络、反向传播、CNN、RNN、Transformer。\n4. AI基础软件工程:分布式训练、模型压缩、边缘推理、MLOps。\n5. 领域进阶:计算机视觉、自然语言处理、强化学习、生成模型。\n\n## 第二部分:基础篇——机器学习核心概念与原理解析\n\n### 2.1 监督学习:从标签中学习\n\n监督学习是绝大多数应用的基础。给定输入-输出对$(x, y)$,模型学习映射$f: x \\rightarrow y$。常见算法:\n- 线性回归:拟合连续值,最小化均方误差。\n- 逻辑回归:解决二分类,输出概率。\n- 支持向量机:寻找最大间隔超平面。\n- 决策树与随机森林:基于特征分裂,可解释性强。\n- 梯度提升机(如XGBoost、LightGBM):集成弱学习器,精度高。\n\n代码示例(scikit-learn):\n`python\nfrom sklearn.linearmodel import LogisticRegression\nfrom sklearn.datasets import loadiris\nX, y = loadiris(returnXy=True)\nmodel = LogisticRegression(maxiter=200)\nmodel.fit(X, y)\nprint(model.predict(X[:5]))\n`\n\n### 2.2 无监督学习:发现隐藏结构\n\n无监督学习没有标签,目标是从数据本身挖掘模式:\n- K-Means:将样本划分为K个簇。\n- 主成分分析(PCA):降维,保留最大方差方向。\n- DBSCAN:基于密度的聚类,可发现任意形状。\n- 自编码器:神经网络降维与特征学习。\n\n### 2.3 模型评估与选择\n\n- 训练集/验证集/测试集:避免过拟合。\n- 交叉验证:K折,更稳健的性能估计。\n- 评估指标:准确率、精确率、召回率、F1、AUC-ROC、均方误差。\n- 偏差-方差权衡:欠拟合与过拟合的平衡。\n\n`python\nfrom sklearn.modelselection import crossvalscore\nscores = crossvalscore(model, X, y, cv=5)\nprint(scores.mean())\n`import numpy as np\nfrom sklearn.linearmodel import LogisticRegression\nfrom sklearn.datasets import loadiris\nfrom sklearn.modelselection import traintestsplit\nfrom sklearn.metrics import accuracyscore\n\n# 加载数据\niris = loadiris()\nX = iris.data\ny = iris.target\n\n# 划分训练集和测试集\nXtrain, Xtest, ytrain, ytest = traintestsplit(X, y, testsize=0.2, randomstate=42)\n\n# 训练逻辑回归模型\nmodel = LogisticRegression(maxiter=200)\nmodel.fit(Xtrain, ytrain)\n\n# 预测与评估\nypred = model.predict(Xtest)\naccuracy = accuracyscore(ytest, ypred)\nprint(f\
如若转载,请注明出处:http://www.hbxwr.com/product/46.html
更新时间:2026-09-19 15:32:38